PDF 看似簡單:打開、閱讀、編輯、轉換、分享,好像一氣呵成。但凡是處理過複雜 PDF 的人都知道,實際情況往往沒這麼單純。掃描回來的合約可能歪斜、有陰影,或是字跡褪色;學術論文可能採用多欄排版、混用字體、加上腳註,版面相當緊湊;技術圖面則可能包含圖層、向量物件、裁切圖片與各種註解。而一旦開始編輯,哪怕只是一處小修改,都可能連帶影響字體、物件位置、註解,甚至是周圍的整個版面。這也是為什麼我們不斷觀察、反覆測試,並且針對每個細節用心設計。
我們終於在六個面向完成細緻的調整,PDNob 重新打造 PDF 使用體驗,以應對上述複雜情況:OCR 前置處理、閱讀模式編輯、翻譯、大型文件渲染、註解追蹤,以及 AI 工具呼叫。我們花了很多時間在那些你可能察覺、也可能沒注意到的細節上——但只要出錯,這些細節就會造成不必要的時間浪費。目標很單純:讓複雜的 PDF 工作更可預期、更有效率,也更好掌控。

一、進階 OCR:掃描 PDF 辨識更精準
OCR 前置處理適用各種文件
為什麼掃描 PDF 總是比預期更凌亂
有時你在手機上打開一份掃描合約,按下 OCR,結果卻看到:義體英文變成亂碼、日期格式錯亂、電話號碼少了一碼。大家往往把問題怪到辨識引擎頭上,但大多時候,源頭其實是那張圖片:掃描時歪了一角的頁面、帶有陰影的收據、字跡磨損的舊書,或是沾滿雜點的傳真頁。
把這張原始圖片直接送進 OCR 引擎,錯誤在辨識開始前就已經發生。這也是為什麼我們把前置處理獨立出來,當成一個可以個別調整的步驟。
我們如何為凌亂掃描件重建 OCR 流程
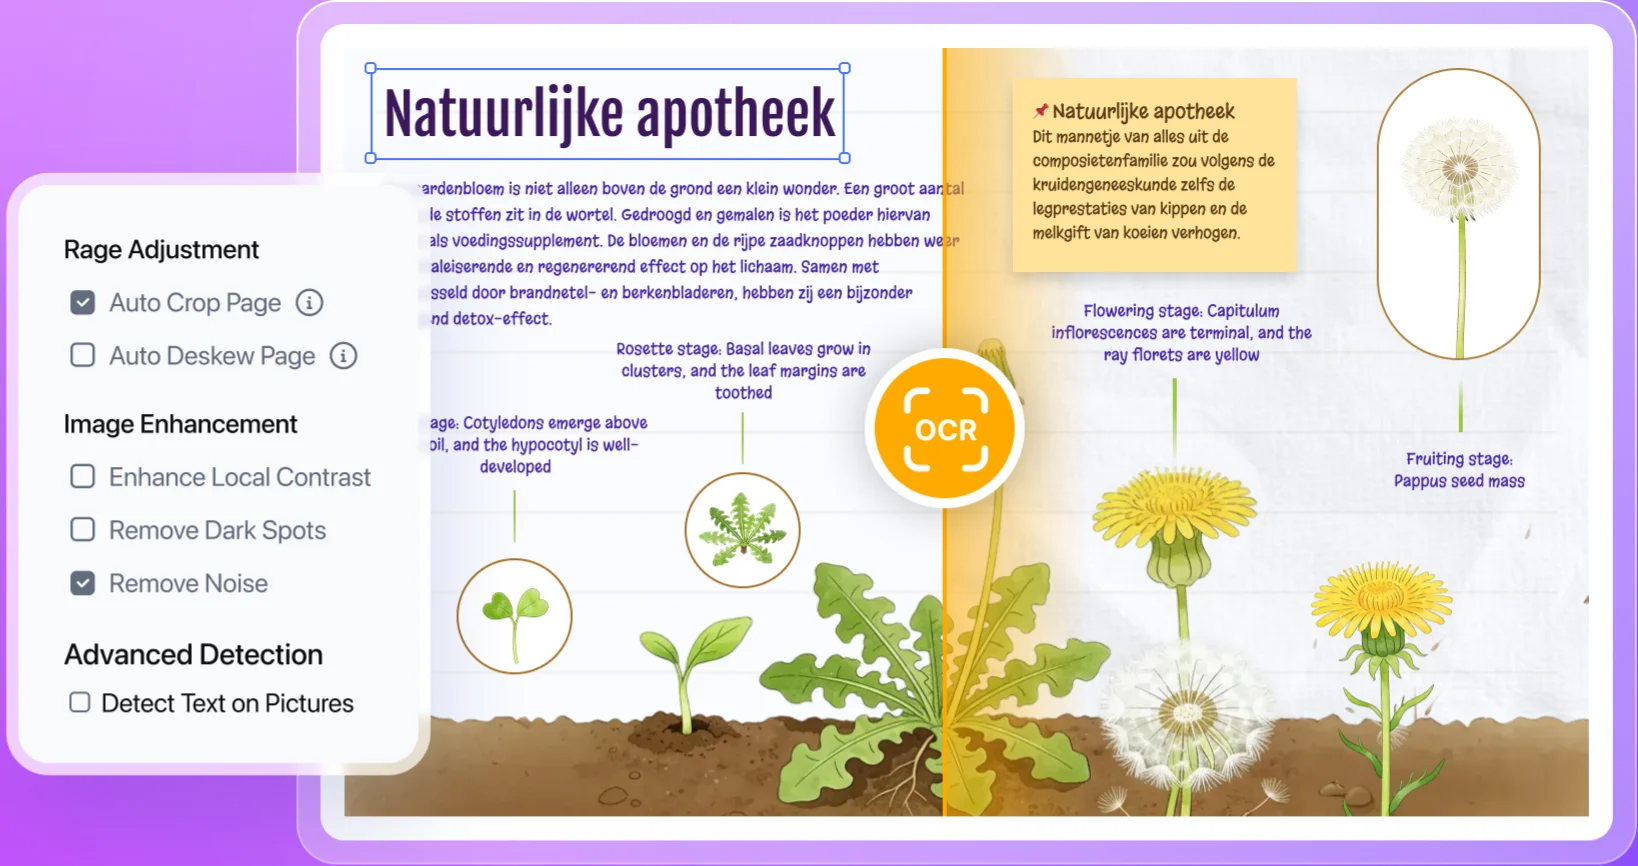
我們與數位化合約的法律團隊、修復舊期刊的檔案人員,以及用手機拍攝收據擷取文字的外勤人員合作數月,不斷反覆打磨 OCR 流程。我們聽到最多次的回饋都是同一句:大家習慣怪辨識模型,但真正的問題往往出在源頭圖片。因此我們從頭重建前置處理,提供五個可獨立開關的選項,讓你依照文件實際狀況來決定要不要啟用。
-
自動裁切頁面:自動偵測並裁掉邊框、留白與空白處,只把文件本體送進辨識器。
-
自動校正傾斜頁面:將傾斜的頁面轉正為垂直方向,適合拍攝在桌上的書籍,或批次掃描的頁面。

-
增強局部對比:針對褪色、過曝或低亮度的掃描件提升局部對比,讓模糊的字跡變得清晰可讀。
-
移除黑點:清除舊影印本與傳真頁上的零散黑點與雜質。
-
去除雜訊:撫平低光源手機照片中顆粒狀的背景雜訊。
-
偵測圖片中的文字:可獨立控制圖片內文字的偵測,讓你只擷取內文,或略過圖說中的文字。

在一份中英混排型錄頁面的內部測試中,PDNob OCR 達成 93.7% 的辨識率,耗時僅 10 秒。
PDNob OCR 的優勢所在
多數編輯器採取一體適用的做法:引擎直接接收原始掃描件就立刻開始辨識。PDFelement、Foxit、UPDF 與 WPS 的研發重心都放在辨識端,因此前置處理普遍較輕量,結果也更仰賴輸入品質。PDNob 現在能把前置處理做成一個獨立、可調的階段。
 請滑動以檢視
這如何優化你的 OCR 工作流程
關鍵不在於「有沒有 OCR」,而是先透過自動前置處理讓文件更適合 OCR,從一開始就拉高辨識正確率。我們不會用同一套方式對待每一份掃描件,而是讓 OCR 流程順應源頭文件的狀態。PDNob OCR 具備獨立的前置處理階段,能針對歪斜、陰影、褪色等不同掃描狀況分別調整,讓後續辨識更穩定。以下幾種情況特別受用:
- 從手機拍攝的合約與簽署協議中擷取文字
- 將頁面可能歪斜或褪色的舊書與期刊數位化
- 從低光源的收據、發票與報帳單中擷取文字
- 轉換混合掃描、公式與圖表的多格式研究論文


二、在複雜文件上也能穩住版面的編輯
我們在編輯功能上做了六項調整,讓 PDNob 在那些累積起來能省下數小時的小編輯上保持領先,段落邏輯、選取框、圖層、字體處理,以及格式保留。
閱讀模式下的段落編輯
為什麼改個錯字也要點五次
假設你看到一份 60 頁合約的一半,才發現第 12 頁有個錯字。在大多數 PDF 編輯軟體裡,你得離開閱讀畫面、切到編輯模式、找游標、改錯字,再切回來。改一個字要切換五次。放到長文件裡,這些切換次數就很可觀了。
我們如何去掉編輯模式的切換
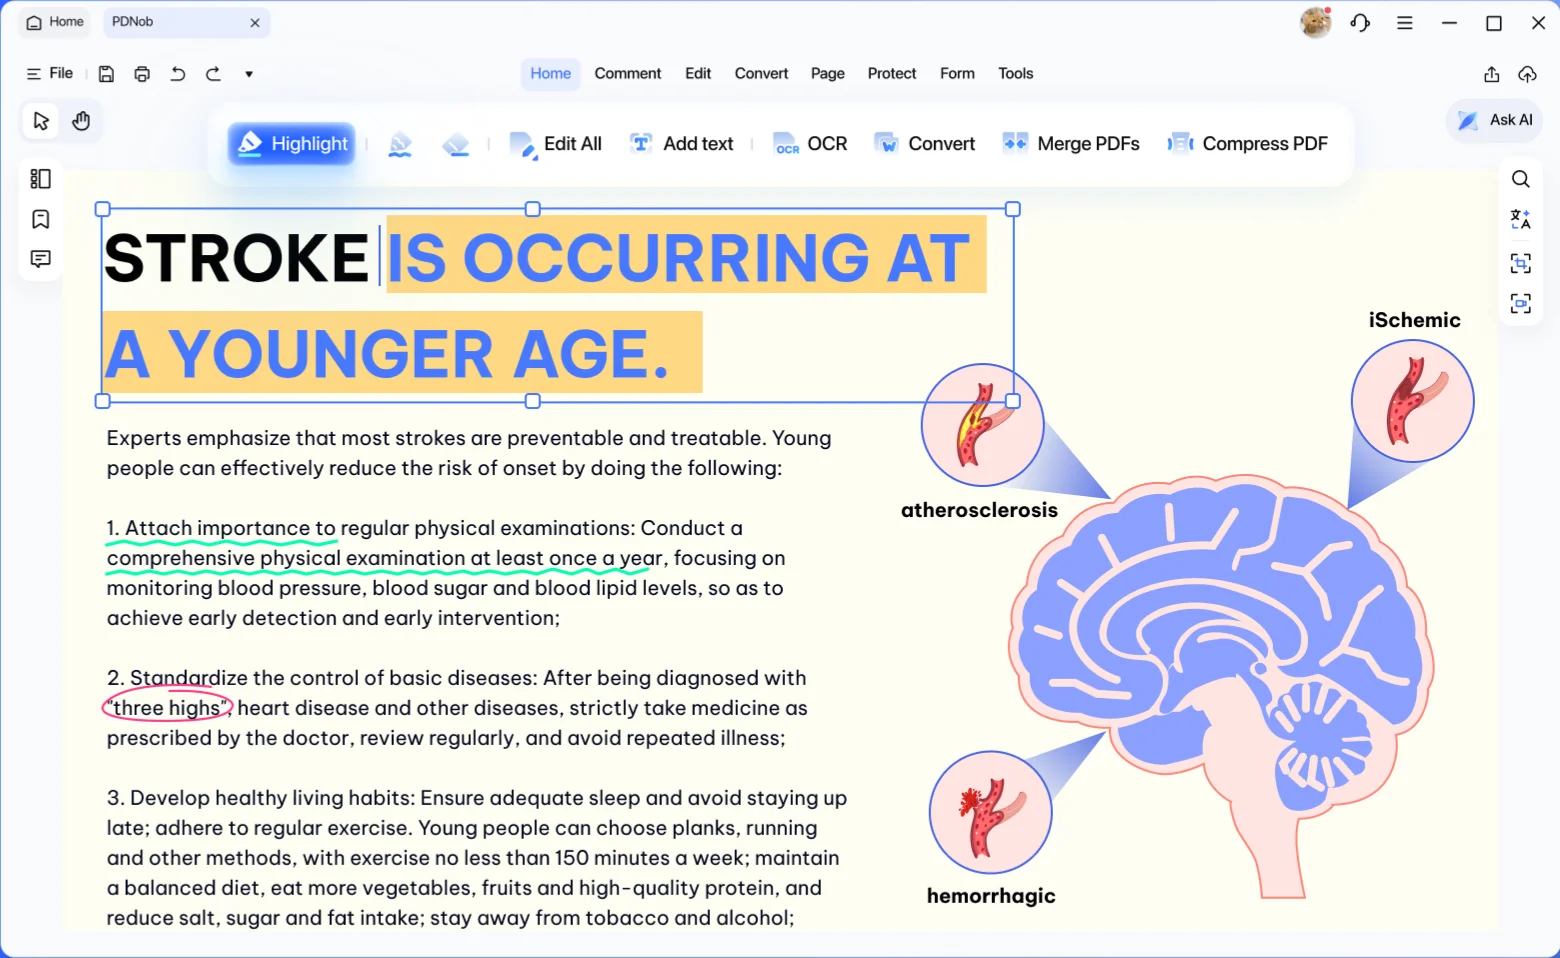
我們看著法律審閱者與編輯人員在長文件中不斷因模式切換而浪費時間,於是重新設計了「先讀再編」的流程,改一個字要切換五次實在太多。我們把點擊即編輯設為預設:在閱讀畫面中點任意文字,游標就精確落在你點的位置,直接開始輸入。粗體、斜體、字體與大小都會沿用原樣式,因此編輯內容能自然融入,不必重新排版。
- 隨處點擊即編輯:點任意文字就能開始編輯,不需切換模式,也沒有額外的工具列步驟。
- 游標落在點擊處:插入點會精確出現在點擊位置,而不是上一段或下一段。
- 保留樣式:粗體、斜體、字體與大小都會保留在原始文字段落上。
其他 PDF 編輯軟體要你多點幾次
在大多數 PDF 編輯軟體裡,改個錯字得先離開閱讀畫面、切到編輯模式、找游標、改完再切回來。有些工具現在已能讓游標落在閱讀畫面,但編輯仍需要工具列確認。PDNob 現在提供從閱讀畫面直接編輯,中間不需要任何工具列步驟。
請滑動以檢視
這樣的設計如何替你省力
概念很簡單:既然你已經看著想修改的文字,就不需要為了編輯而離開閱讀畫面。這代表你花更少時間和選取控制點搏鬥,把更多時間用在文件本身。這類 PDF 編輯需求在合約與報告中極為常見,直接編輯能顯著減少來回切換的干擾。以下情況特別適用:
- 一邊閱讀合約、一邊修正錯字與日期錯誤
- 更新草稿報告中的圖表與引用數據,同時不跑版
- 在把文件往下傳之前,先在閱讀畫面清理 OCR 輸出
複雜物件的穩定選取框
為什麼在其他工具選取不規則圖片很吃力
你可能碰過這種情況:手邊是一份設計密集的 PDF,想抓取一張旋轉過的圖片或一個不規則裁切的形狀。選取框卻只蓋住一半,或是你一旋轉它就從物件上跳開。結果你花在跟選取控制點纏鬥的時間,比真正移動物件還多。
我們如何讓不規則物件的選取穩定下來
為了解決這個問題,我們重做了選取運算。在我們支援的設計與編輯流程中,選取這一步是最容易被忽略的時間黑洞。在 PDF 裡選取一個物件聽起來很簡單,直到那個物件被旋轉、裁切、形狀不規則,或是用自訂路徑畫出來。我們現在會把不規則物件、裁切圖片與自訂路徑包進一個乾淨的邊界框,在旋轉、縮放與斜切時都能保持對齊。
- 不規則路徑支援:裁切圖片與自訂形狀都能得到精準、完整包覆的選取框。
- 操作時保持穩定:選取框在旋轉、縮放與斜切時都能維持對齊。
- 各類物件行為一致:圖片、向量路徑、形狀與文字框的行為全都一致。
各家編輯器如何處理選取框
不同編輯器處理不規則形狀的方式各異。PDFelement 對部分物件的包覆並不完整。Foxit 與 WPS 的選取框在旋轉或縮放時可能會從物件上漂移。PDNob 現在提供一套在各類物件間都一致的選取運算。
請滑動以檢視
選取穩定度如何讓流程更順
這些細節可能不會出現在功能清單上,但在處理複雜的設計型 PDF 時卻很關鍵。以下情況特別適用:
- 在設計型 PDF 中選取裁切圖片來移動或縮放
- 操作自訂形狀與不規則路徑時不讓選取框消失
- 旋轉浮水印與標章時,選取框不會漂移
精準的圖層與上下層順序調整
當浮水印蓋在文字上,物件堆疊為何重要
你移動浮水印、標誌或背景圖,圖層順序卻不如預期地改變——浮水印最後遮住了標題,或是編輯文字時悄悄把物件推到另一個圖層。要把順序排對,往往得嘗試好幾次。
我們如何打造文件層級的圖層控制
我們看著設計與報告團隊為了排對順序白白浪費時間,於是重建了文件層級的堆疊,移動浮水印不該把底下的標題推到另一個圖層。我們現在提供文件層級的物件堆疊順序控制。你可以把任何物件移到堆疊的最上層或最下層,而且相對位置在編輯文字後依然保留。對於從其他工具匯入、設計密集的文件,巢狀群組的階層也會完整保留。
- 真正的全域上下層:不論是否巢狀,都能把任何物件移到堆疊最上層或最下層。
- 圖層感知的文字編輯:編輯文字時,物件與其他圖層的相對位置保持不變。
- 巢狀群組支援:帶內部圖層的複雜群組會保留其階層。
物件層級與文件層級的上下層順序
多數編輯器都提供某種圖層控制,但深入程度不一。Foxit 支援全域調整,不過相對圖層位置在編輯文字時可能位移。PDFelement 與 WPS 僅涵蓋基礎的圖層移動,沒有文件層級的檢視。PDNob 現在把整份文件的堆疊順序整合進同一個工作區。
請滑動以檢視
應用情境
這些細節可能不會出現在功能清單上,但在處理複雜 PDF 時卻很重要。以下情況特別適用:
- 調整浮水印、標誌與背景圖形之間的上下重疊
- 在設計草稿中把圖片堆到文字或形狀後方
- 整理從設計軟體匯入的多圖層 PDF
在複雜排版中更聰明的段落辨識
為什麼編輯雙欄排版常常跑版
假設你打開一份雙欄的學術論文,只想修正摘要裡的一句話。編輯之後,版面卻變了:右欄的段落跳到左欄、標題不再對齊,腳註也脫離了它原本要標記的本體。看似簡單的編輯,卻悄悄重組了整個頁面。
我們如何為複雜排版重新訓練段落模型
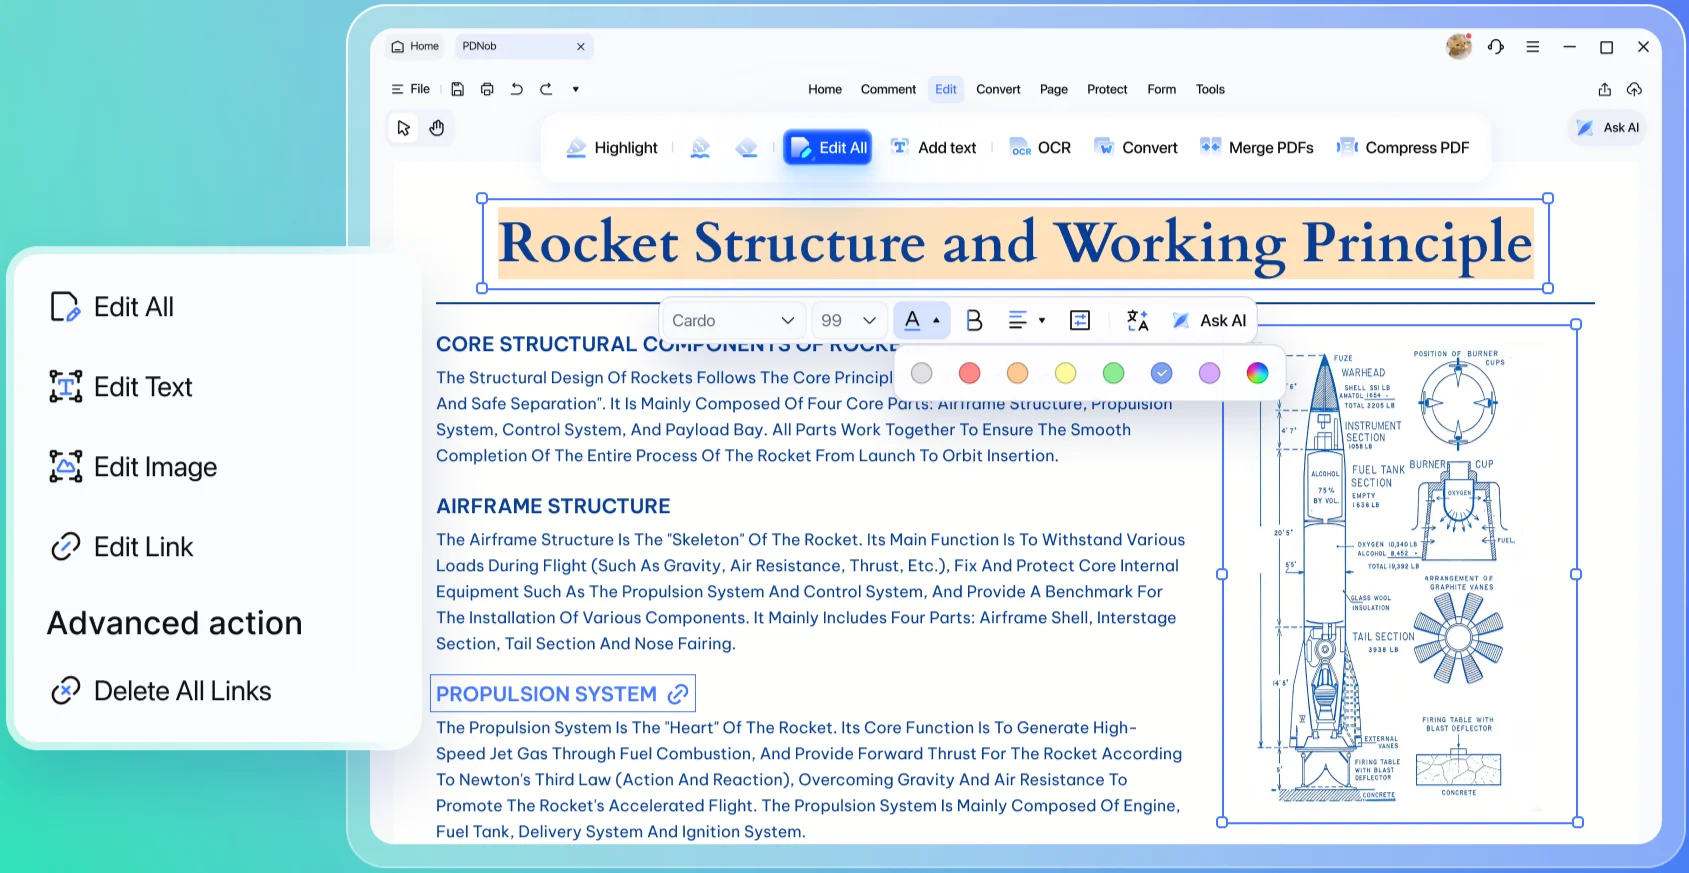
我們看著一次雙欄編輯悄悄重組了整個學術頁面,於是針對複雜排版重新訓練了段落模型。PDF 頁面在視覺上可能包含多欄、標題、腳註與混合格式,但底層的文字結構往往沒那麼直觀。一旦底層結構被誤讀,編輯就會讓版面崩掉。在一份 309 頁的內部測試集中,F1-Core 分數較上一版提升了 1.55%;而在 Adobe、Foxit、UPDF 與 PDFelement 的跨工具測試中,PDNob 在複雜排版上以 89.88% 的 F1 拿下第一。
- 多欄偵測:精準辨識跨欄的段落。
- 混合格式區段:在混合格式的頁面中辨識段落邊界。
- F1 分數提升:在 309 頁測試集上,F1-Core 較上一版高出 1.55%。
- 複雜排版表現居冠:在五款工具的比較測試中,我們的 F1 達到 89.88%。
段落讀取在哪裡成為瓶頸
一款編輯器能否保留複雜版面,很大程度取決於它讀取底層結構的能力。Adobe、PDFelement、UPDF 與 Foxit 都能妥善處理標準文件,但在我們測試的多欄、混合格式文件上,真正的差異就在底層段落讀取。PDNob 現在提供專為多欄、混合格式情境訓練的段落辨識。
請滑動以檢視
它如何融入你的工作
這項優化的價值很直接:排序只要設一次就夠。浮水印、標誌與背景圖形之間的堆疊會留在你擺好的位置,不必每次編輯文字後都重新排層。以下情況特別適用:
- 編輯多欄學術論文,同時不破壞段落邊界
- 重整區段採用不同樣式的混合格式報告
- 處理混雜標題、內文與腳註的書籍排版
跨應用程式保留格式的複製
複製標題格式為什麼會出問題
在其他 PDF 編輯軟體裡,如果你在 PDF 中選取一個粗體標題,複製後貼到 Word 或 WPS 文件,粗體就不見了。編號清單也是:貼上去後編號退回成純文字。字帶過去了,結構卻沒帶過去。
我們如何讓複製貼上保留格式
我們注意到編輯者與報告撰寫者往往在每次貼上後都得重做一遍格式,於是著重於複製貼上的忠實度。把文字從 PDF 複製到另一個應用程式,不該代表要從頭重建格式。現在我們會保留格式屬性,字體、大小、粗體、斜體、編號清單——當文字在 PDF 編輯工具與常見的文書軟體之間移動時。
- 高忠實度文字複製:複製文字時保留粗體、斜體與字體樣式。
- 文書軟體相容:適用於 Word、WPS 與其他常見編輯器。
- 免於重排格式:貼上後不必重新套用格式。
複製貼上往返後哪些格式還在
不同工具處理複製貼上忠實度的方式各異。WPS 向來能保留格式。Adobe、PDFelement、UPDF 與 Foxit 在粗體、斜體與清單能否穩定通過往返的表現則時好時壞。PDNob 現在提供在複製貼上往返中都能穩定保留的格式。
請滑動以檢視
這如何省下重複工作
這項改進的目標不只是把字複製過去,而是要保留讓這些文字有用的結構與格式。以下情況特別適用:
- 把引言移入 Word 報告,粗體與斜體都保留
- 把編號清單轉入 WPS 文件,編號不消失
- 在組裝報告時,於文書軟體間複製帶樣式的標題
- 從 PDF 來源補充研究筆記,同時保留原始格式
更快速、更精準的字體比對
字體替換如何悄悄讓長文件編輯變複雜
你打開一份 300 頁的手冊,開始插入新章節。寫到一半,你發現新段落的字體和原文略有不同,原來是引擎悄悄替換了它比對不到的字體。等你察覺時,整份文件在各章之間已經看起來不一致了。
我們如何重建字體比對引擎
我們重建字體比對引擎,因為沒有什麼比在章節中途悄悄換字體更快破壞長文件的一致性。字體這種細節,往往要等出問題才會被發現。我們的引擎現在能處理更廣泛的字體變化,包含粗體與斜體樣式;同時減少那些突如其來的字體替換。在一項插入超過 10,000 字的內部測試中,該操作在測試條件下約耗時 5 到 6 秒。
- 粗體與斜體變體:更完善支援更多字重與樣式。
- 減少替換:引擎在文件中途替換字體的情況更少。
- 大型插入更快速:在測試條件下,插入 10,000 字以上約 5 到 6 秒。
為什麼字體處理只在長篇插入時才顯現
字體比對是一個差異只會在長文件上顯現的領域。我們的測試中,同樣插入 10,000 字以上,WPS 約 9 秒、PDFelement 25 秒以上、UPDF 約 1 到 2 分鐘。PDNob 現在提供更快的字體比對,在長篇插入時仍能保留原始字體樣式。
請滑動以檢視
它如何節省你的編輯時間
這項強化代表一致的字體處理,能在長文件修訂的最終成果上帶來明顯差異。以下情況特別適用:
- 把大段文字插入論文草稿,過程中不替換字體
- 替既有書籍新增章節,同時保留原始字體樣式
- 批次更新手冊,而一致字體對品牌識別至關重要
三、翻譯 PDF 不破壞原始版面
我們的翻譯模式有兩種,涵蓋機器翻譯通常會弄壞 PDF 的情況,雙語閱讀用於抽檢,全文翻譯用於成品輸出。
並排雙語閱讀
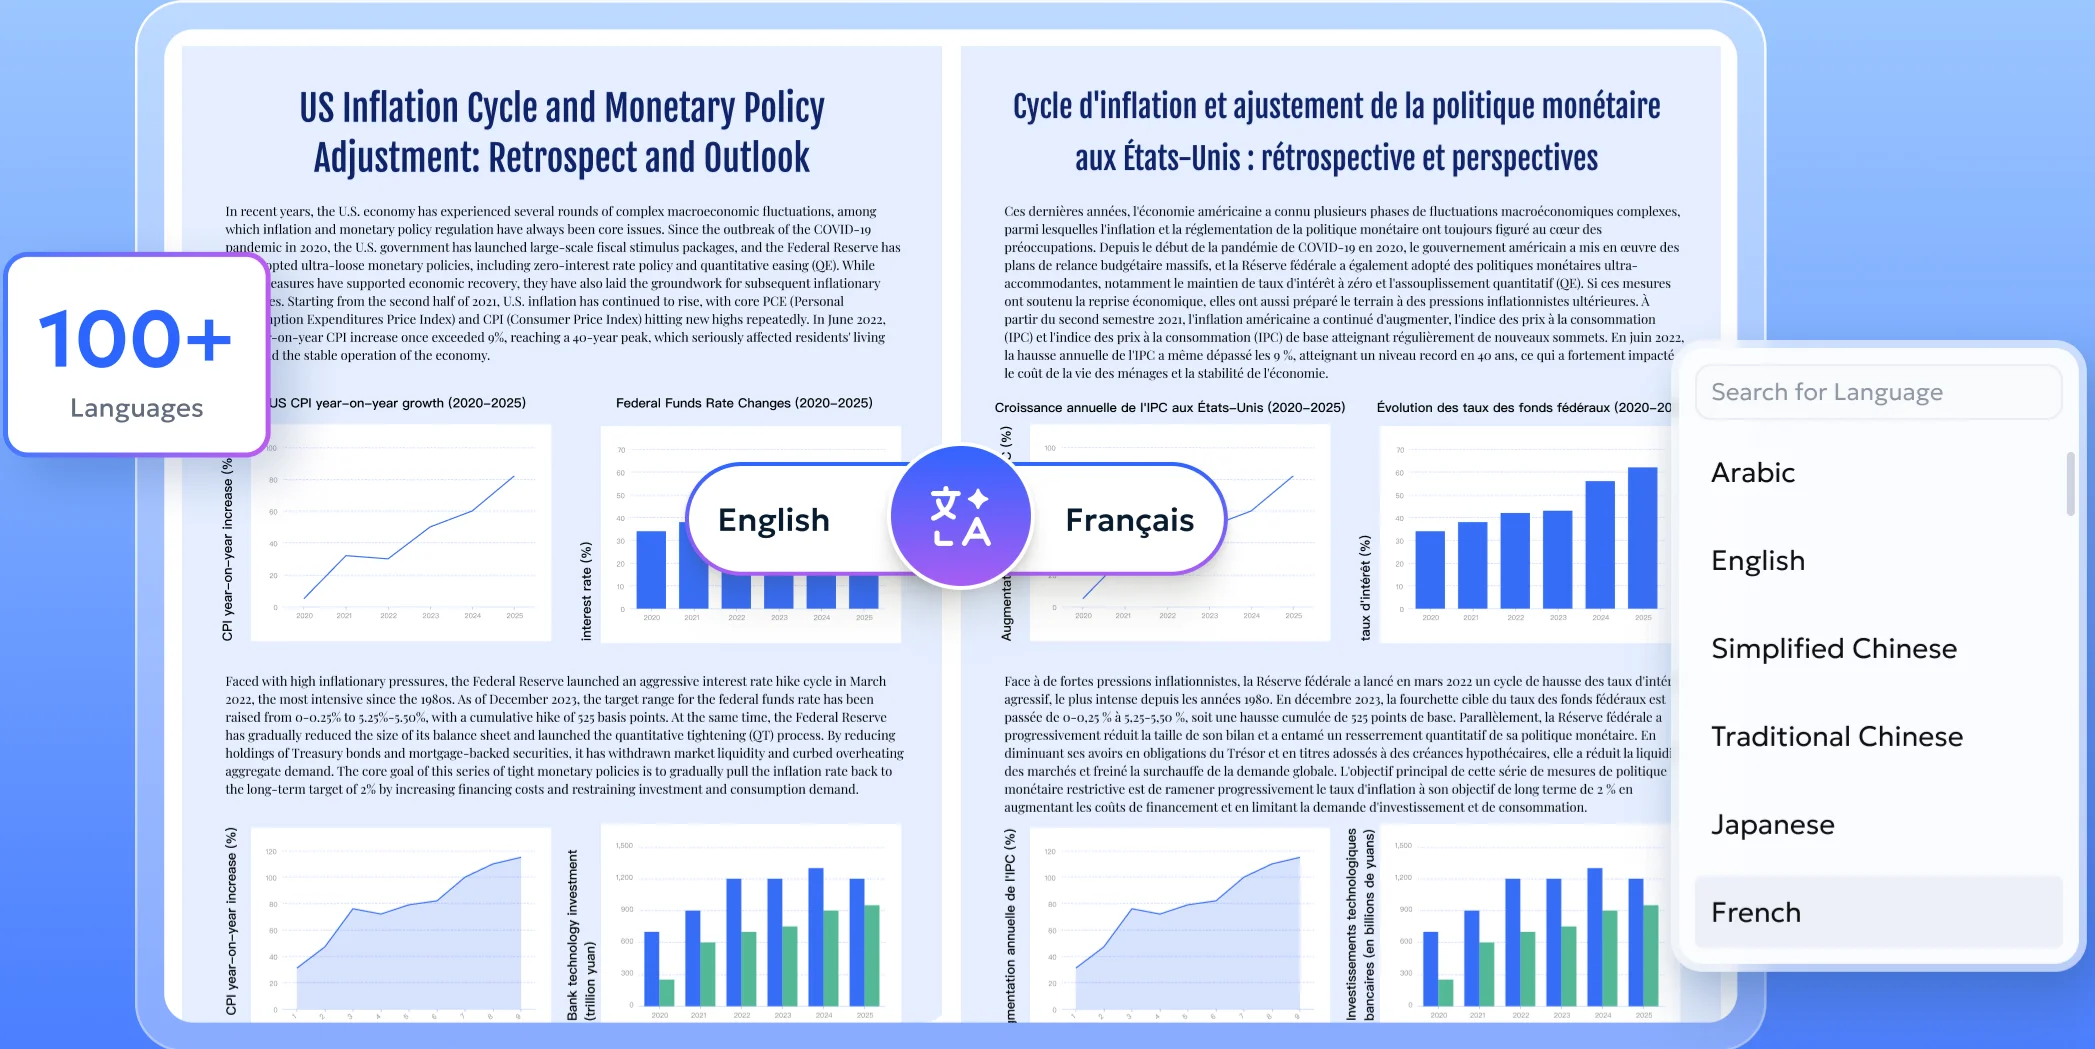
為什麼讀外文 PDF 要開兩個瀏覽器分頁
對多數學生或研究人員來說,這是再常見不過的場景:你正讀著一份 30 頁的英文研究論文。想查一個詞,就得選取句子、複製、切到瀏覽器分頁、貼進翻譯工具、讀結果、再切回來,還得努力回想自己讀到哪了。等你讀完摘要,閱讀節奏早就斷了。
我們如何為讀者帶來雙語檢視翻譯
為了省下這套費時的流程,我們看著研究人員與審稿者被五個瀏覽器分頁打斷閱讀節奏,於是打造了閱讀器內的雙語模式。我們把原文與譯文放在同一個視窗:原文在一側、譯文在另一側,當你在兩者間移動時,對應的段落會同步亮起。你始終待在 PDF 裡。
- 雙語檢視:原文與譯文同時可見,逐段對照。
- 動態翻譯更新:隨著你在文件中捲動,翻譯面板會即時刷新。
- 懸停即高亮:在任一側懸停,就能高亮另一側對應的段落。
- 不必切換分頁:翻譯直接在 PDF 閱讀器內執行,不用第二個應用程式,也不必複製貼上。

翻譯在哪裡進行:閱讀器內或瀏覽器裡
多數編輯器不是把你導向獨立的翻譯工具,就是根本沒有雙語檢視。UPDF 的網頁版支援並排翻譯。PDFelement、Foxit 與 WPS 通常都沒有。PDNob 現在提供貼著原文、不需要第二個工具的翻譯。
請滑動以檢視
它如何改善你的雙語閱讀體驗
你待在 PDF 裡就好,不必反覆把文字複製貼上到另一個應用程式。以下情況特別適用:
- 一邊看英文研究論文與期刊,一邊對照翻譯
- 研讀外文的技術手冊與規格表
- 審閱翻譯後的合約與法律文件,確認準確性
- 在地化審核時,比對原文與譯文的行銷文案
保留版面的全文翻譯
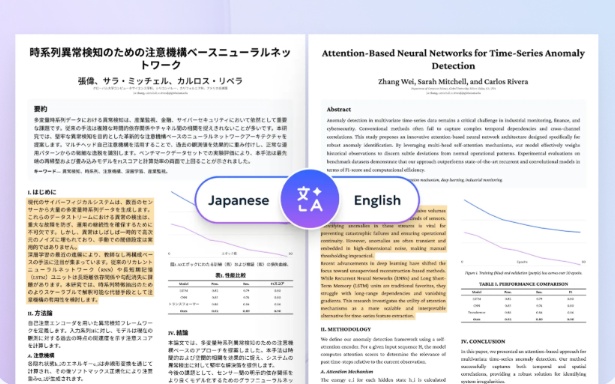
為什麼機器翻譯常常搞壞版面
你可能碰過這種情況:把一份德文手冊丟進機器翻譯。英文讀起來沒問題,但每一頁都超出了右邊界,因為譯文比原文長,版面就破了。表格被拉長、標題換成兩行,整份文件看起來像草稿。
我們如何讓全文翻譯保留版面
我們把全文翻譯重建為「逐文字區塊」的決策,因為多數翻譯工具會讓德文手冊超出頁面邊緣。全文翻譯幾乎一定會改變文字長度,德文比英文長、中文比英文短、法文則介於兩者之間。多數 PDF 翻譯工具會把新文字以原字體大小塞進原始版面,然後就溢出了。我們現在會逐文字區塊測量譯文長度,並自動調整字體,讓頁面不需手動微調就保持易讀。
成品讀起來仍應像同一份文件,只是換了語言。對翻譯技術文件、學術論文、訓練教材或商務文件的使用者來說,保留文件的結構,重要性不亞於翻譯本身正確與否。
- 自適應字體縮放:字體大小會依每段譯文的長度自動調整。
- 區塊層級的版面保留:文字會留在原始的段落與欄位邊界內。
- 易讀的產出:譯文頁面維持視覺平衡,不溢出、也不會出現奇怪的空隙。
各家翻譯工具如何對待原始版面
不同翻譯工具處理版面保留的方式各異。WPS 保留字級樣式,但在複雜格式上可能吃力。PDFelement 保留基礎樣式,但還原較粗略。Foxit 則著重簡單文件的速度與正確性。PDNob 現在提供把版面保留當成「逐文字區塊」決策的翻譯。
請滑動以檢視
你在哪裡感受到差異
這項設計的目標是保留段落結構、欄位邊界、頁面排版、表格、頁首頁尾,以及整體易讀性。以下情況特別適用:
- 翻譯使用者手冊與技術規格,同時保留易讀性
- 把學術論文譯成第二語言,且不破壞公式或圖表
- 製作訓練教材與新人文件的雙語版本,且保留複雜版面
四、不再等待,流暢閱讀大型複雜 PDF
PDNob 閱讀功能的兩項渲染能力,決定了你打開 PDF 時的體感:漸進式載入帶來速度,廣泛的格式相容性則應付那些雜亂的檔案。
更快速的檔案渲染
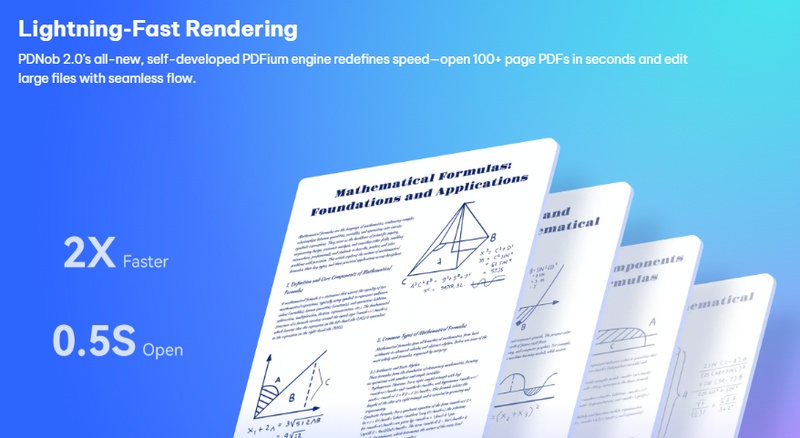
等 500 頁 PDF 開 20 秒,感覺很漫長
在傳統的 PDF 編輯器中,如果你雙擊一份 500 頁的產品手冊,可能得看著白畫面等 15 到 20 秒,第一頁才出現。等你載完,早就忘了自己是為了什麼打開它的。打開一份文件,不該像在等資料庫回應。
我們如何用漸進式渲染縮短開啟時間
為了縮短等待時間,我們打造了漸進式渲染,因為等 500 頁 PDF 開 20 秒實在無法接受。我們採用漸進式渲染,第一屏內容立刻出現,其餘文件在背景串流載入。500 頁的大型手冊、設計檔、圖片密集文件都能在數秒內開啟,完整文件還在解析時,第一屏就已經看得見。
在一項五款工具的冷啟動效能測試中,PDNob 僅 0.25 秒,是五款中最早開出畫面的。在相同工作量下,記憶體用量比 UPDF 與 PDFelement 少了約 66%。
- 漸進式渲染:完整文件解析完成前,第一屏就已出現。
- 更快的開啟速度:大型文件數秒開啟,而非數十秒。
- 減少白畫面等待:使用者一點開就能看到內容。
是什麼拖慢了 500 頁的開啟
冷啟動速度與大型文件處理,各編輯器表現不一。Foxit 與 PDFelement 通常能妥善處理標準文件,但遇到複雜文件就變慢。我們的測試中,UPDF 在複雜文件上最慢。PDNob 現在提供首屏渲染,在複雜工作量下的記憶體用量比 UPDF 與 PDFelement 少約 66%。
請滑動以檢視
PDNob 在哪裡省下了等待時間
對一份 500 頁的文件,我們只希望漸進式載入能讓你盡快開始閱讀。以下情況特別適用:
- 毫無延遲地打開數百頁的研究論文、學位論文與報告
- 載入技術手冊與產品規格表,方便快速查閱
- 檢閱圖片密集的設計草稿與型錄
- 處理橫跨數百頁的掃描文件合輯
更強的渲染相容性
為什麼有些 PDF 在多數閱讀器裡打不開
如果你在手邊的閱讀器打開一份存成 PDF 的 CAD 匯出檔,卻看到錯誤、空白頁或圖片遺失,這份檔案在某個閱讀器裡好好的,在別的卻壞掉,原因可能是:有些 PDF 來自專門的設計工具、被反覆編輯與重新匯出,或者根本沒有嚴格遵循 PDF 規格。
我們如何處理非標準 PDF
我們針對非標準 PDF 做了大量測試,因為打開一份報錯的 CAD 匯出檔,可能是最令人挫折的時刻之一。我們設計的渲染管線能處理廣泛的 PDF 結構,複雜的向量圖形、路徑與形狀、裁切、圖層、透明與遮罩,以及那些沒嚴格遵循預期結構的 PDF。一般閱讀器可能報錯的地方,我們會盡力把看得到的內容渲染出來。
這對 CAD 匯出檔、工程圖面、設計檔,以及經過多輪編輯與重新匯出的文件來說,影響最大。
- 向量圖形支援:精準處理複雜路徑、形狀與裁切。
- 圖層與遮罩相容:支援多通道圖層與透明遮罩。
- 優雅降級:非標準檔案會被渲染出來,而不是報錯。
非標準 PDF 在其他閱讀器裡會怎樣
對非標準 PDF 的相容性,往往是各家編輯器分高下的地方。我們的測試中,Foxit、PDFelement 與 UPDF 都在某些非標準 PDF 上出現錯誤或空白頁。PDNob 現在提供對非標準 PDF 的優雅渲染,那些其他閱讀器可能直接拒絕的檔案。
請滑動以檢視
它如何融入你的閱讀體驗
你不需要理解任何底層結構,只要文件能正確開啟與顯示就好。以下情況特別適用:
- 打開存成 PDF 的 CAD 匯出檔與工程圖面
- 閱讀由專門設計或排版軟體產出的 PDF
- 載入經過多次編輯與重新匯出的 PDF
五、為 PDF 加註解,同時跟住你的編輯
PDNob 註解功能有兩種行為,讓標記在每一輪修訂中都派得上用場,隨文字編輯移動的註解,以及你需要乾淨畫面時的一鍵隱藏。
隨文字編輯移動的註解
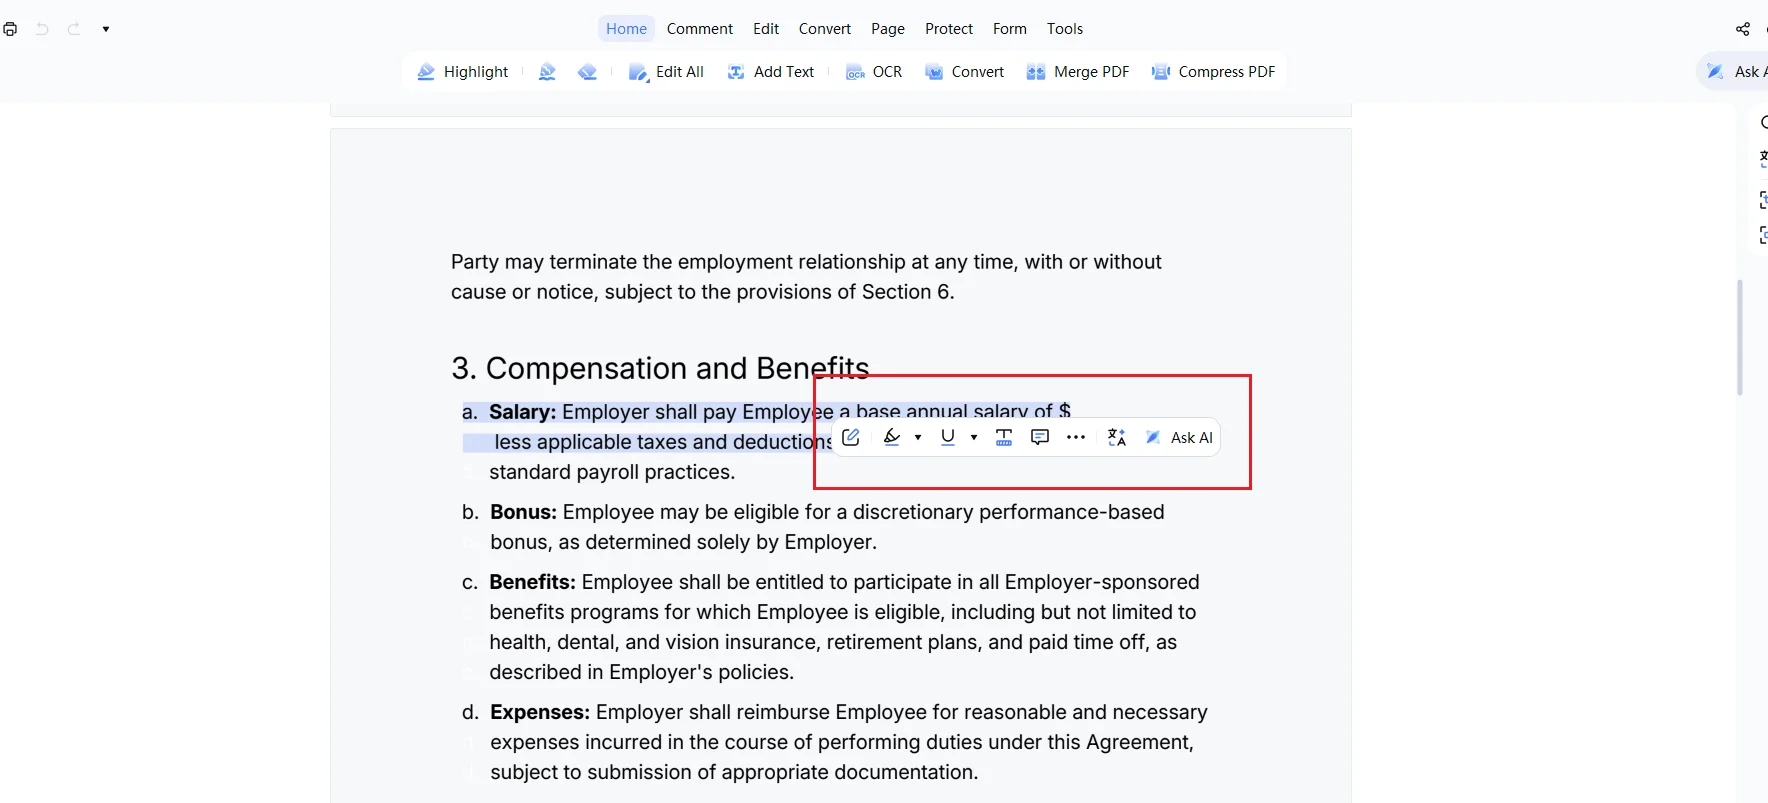
為什麼標記應該跟著你編輯的文字走
這項設計看似不起眼,少了它卻很麻煩。如果你在合約中標記了一條關鍵條款,後來又編輯了它上方的用字。等你回來,標記仍錨定在舊位置,早已不再覆蓋它原本要標示的文字。經過幾輪修訂,你的標記就脫離了它應該標記的文字。
我們如何把註解綁定到文字
我們看著法律與編輯團隊在每一輪修訂後都得重做同樣的標記,於是重建了註解綁定。我們讓註解持續綁定在它所參照的文字上。螢光筆、底線、刪除線與波浪底線都會隨文字一同移動。留言也會留在對應的文字段落上。
- 標記持續性:螢光筆、底線、刪除線與波浪底線都會隨底層文字移動。
- 免手動重新標記:每一輪修訂後都不必重做標記。
- 留言追蹤:留言會留在它所參照的文字段落上。
- 在初次審閱時標記合約,並在後續修訂中保持標記不變
- 標記研究論文中的關鍵句,編輯那些句子時標記不消失
- 審閱草稿報告,而文字修訂與標記是同時進行的
- 一鍵切換:立即顯示或隱藏所有註解。
- 註解保留:隱藏不代表刪除,註解仍附在文件上。
- 免干擾閱讀:檢視乾淨版本,方便審閱或列印。
- 審閱充滿指導老師留言的論文,而不被標記干擾
- 簽署前檢查修訂版合約的最終視覺流程
-
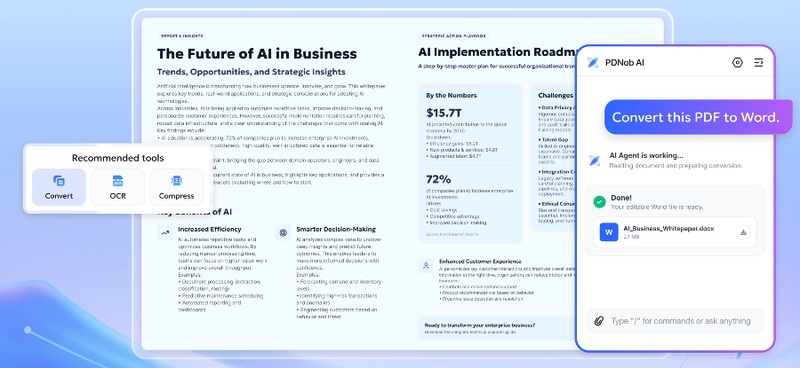
直接呼叫工具:AI 依需求呼叫 OCR、格式轉換、壓縮等 PDF 工具。
-
自然語言觸發:使用者用白話描述需求。
-
回傳產出:AI 直接回傳可用的結果檔。
- 用一句話描述任務,就把 PDF 轉成 Word 或 Excel
- 在同一段對話中串接多個操作,轉換、壓縮、重新命名,通過單次對話完成
-
最新科技指南: 覆蓋系統修復、資料救援與AI 技巧等

-
粉絲限定福利: 各類軟體免費序號 & 專屬折扣定期贈送

-
專屬技術支援: 私訊FB小編解決您的數位煩惱


註解在哪裡失去參照
註解追蹤是各家編輯器分出高下的領域之一。Adobe 有支援。PDFelement、Foxit、UPDF 與 WPS 普遍把註解當成頁面上的固定位置,也就是說,文字一編輯,參照就丟了。PDNob 現在提供能隨底層文字一起移動的註解。
請滑動以檢視
你在哪裡看到差異
你不必每次改完文字就重建註解,可以繼續使用同一組標記。這在合約審閱、學術編輯、報告修訂、文件校對,以及協作審閱流程中都能派上用場。以下情況特別適用:
一鍵隱藏所有註解
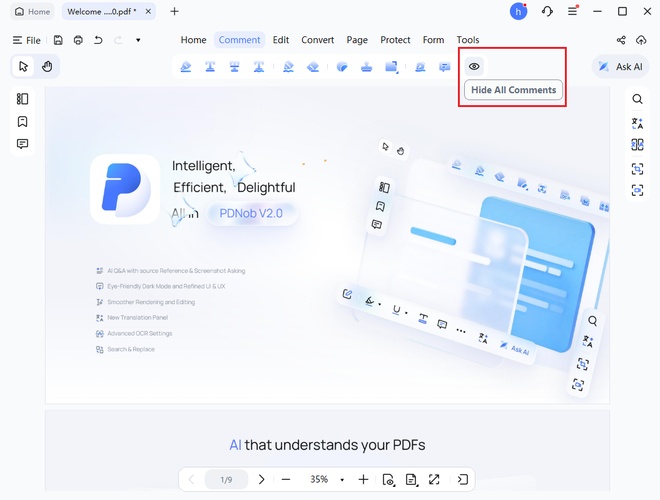
當你需要隱藏註解,而不是刪掉它們
假設你正要送出合約的最終草稿。頁面上佈滿了審閱階段留下的黃色螢光、紅色底線與邊欄留言。你想乾乾淨淨地看這份文件,但又不想刪掉任何努力成果。這正是這項設計的用途。
我們如何打造一鍵隱藏開關
我們打造一鍵隱藏開關,因為隱藏標記不該等同於刪除你的成果。我們讓你一鍵隱藏所有註解。什麼都不會被刪除,註解仍附在文件上。再點一次就回來。這讓你能在審閱模式(有標記)與乾淨閱讀模式(沒有視覺雜亂)之間切換,而不會遺失任何東西。
隱藏標記對你的工作實際做了什麼
Foxit、PDFelement 等也以某種形式支援隨需隱藏,但實作方式不同。有些工具在某些檢視下會把標記刪掉。PDNob 現在提供一個隱藏開關,切換過程中保留每一則註解。
請滑動以檢視
它何時發揮作用
註解仍留在文件中,之後可以再次顯示。這讓你在審閱模式與乾淨閱讀模式之間切換更容易。無論是審閱最終合約、檢查報告的視覺呈現,還是準備列印文件,都能派上用場。以下情況特別適用:
六、用自然語言讓 AI 處理 PDF 工作
為什麼 AI 該動手做,而不只是動口說
「把這份 PDF 轉成 Word」應該一句話就搞定。但在多數 PDF 工具裡,這得先開選單、再選格式、選輸出位置,最後還要確認對話框。其他 AI 助理雖然能回答問題,卻仍要你自己動手,助理開了對話框,等你點。
我們如何打造直接呼叫工具
我們打造直接呼叫工具,因為描述任務本身就該是全部工作,而不是「先開對話框、再點一次」之前的一個步驟。AI 助理能直接呼叫 PDF 工具,OCR、格式轉換、壓縮,執行作業並回傳結果檔。你用白話描述需求,AI 就觸發對應的 PDF 操作,把結果交還給你。
關鍵區別在於:AI 並不是要取代底層的 PDF 引擎,AI 只是提供一個更自然的操作介面,實際工作仍由 PDF 工具執行。結果是:任務從五步流程變成一句話,串接的工作流則濃縮成一段對話。
AI 在哪裡停下、把工作交還給你
不同的 AI 助理處理同一件事的方式各異。Foxit 與 Adobe 支援 AI 驅動的工具使用,但執行深度不一。UPDF 的助理能開對正確的對話框,卻仍要你確認。PDFelement 目前不提供這類呼叫。PDNob 現在提供一個會直接呼叫 PDF 工具並回傳檔案的 AI,不需要第二次確認點擊。
請滑動以檢視
它如何協助你的工作流程
當好幾個機械化操作需要串接時,這特別能替你省時間。以下情況特別適用:
總結
橫跨本文涵蓋的六個面向,OCR 前置處理、閱讀模式編輯、翻譯、大型文件渲染、註解追蹤,以及 AI 工具呼叫,我們不斷回到同一個問題:一份難搞的 PDF 最早會在哪裡出錯?我們又能在出錯之前,悄悄擋下多少?每個面向背後的取捨都很容易被忽略,而我們刻意把它們做得讓使用者不必察覺,只為了讓工作流程更順。
PDF 軟體很容易用功能清單來評斷。但當你真正面對一份難處理的文件,體驗往往取決於那些更細微的地方。一款好的 PDF 編輯器,價值不在功能多寡,而在這些細節是否到位。對我們來說,打造更好的 PDF 產品,不只是疊加更多功能,而是把細節做對。
PDNob 進階功能常見問題
Q1. PDNob 在 Windows 與 Mac 上都能使用嗎?
A1:可以。PDNob 這套 PDF 編輯器在 Windows 與 macOS 上皆可使用,兩個平台的功能完全一致。
Q2. 在 PDF 裡改一個字,需要切到編輯模式嗎?
A2:不需要。在 PDNob 中,於閱讀畫面點任意文字就能開始輸入,游標會出現在你點的位置,原始的字體、大小、粗體與斜體都會保留。
Q3. 每次都要跑完五道 OCR 前置處理嗎?
A3:不需要。每一道,自動裁切、校正傾斜、對比增強、去除黑點與去除雜訊,都能在 OCR 設定中獨立開關,因此你能讓引擎配合文件狀況。
Q4. 雙語翻譯能保留原始版面嗎?
A4:可以。表格、頁首、頁尾與字體都維持在原位。引擎運作在文字圖層而非壓平後的圖像上,並透過字體縮放讓譯文留在原始版面內。翻譯後的合約,除了語言不同,看起來與原文一模一樣。標準的商務文件都能乾淨通過。
Q5. 註解追蹤能在團隊間協作嗎?
A5:可以。PDNob Cloud 會記錄每一則留言、標記與修訂,包含作者、時間戳記與已解決狀態。審閱者在討論串中回覆、將項目標記為已解決,並可篩選出未處理的項目。
 Tennorshare Taiwan
官方FB
想瞭解更多方法與
優惠資訊嗎?
追蹤 Tenorshare 臺灣官方 Facebook,你可獲得: